物理降噪的极限与自适应滤波的核心逻辑
在音频处理领域,所谓的“最大降噪深度”并非一个固定的整数数值,而是取决于信号处理算法对噪声频谱特征的识别精度以及目标语音信号的保留率。传统的固定滤波器往往难以应对动态变化的声学环境,而自适应滤波算法通过实时调整滤波器系数,能够更精准地分离出声源与背景噪声。这种技术路径的核心在于利用参考信号或盲源分离技术,构建一个误差最小化的优化模型,从而在频域和时域同时对噪声进行抑制。
自适应滤波的实现通常依赖于最小均方(LMS)或其变种算法,如归一化最小均方(NLMS)。这些算法通过迭代过程不断更新加权系数,使得输出信号与期望信号之间的误差功率最小化。在这种机制下,系统能够动态跟踪噪声的变化,无论是恒定的低频嗡嗡声还是突发的瞬态噪声,都能通过算法的自适应特性进行不同程度的衰减。这种处理方式避免了传统方法中因参数固定导致的“音乐噪声”残留问题,从而在听感上提供更自然的纯净声音。
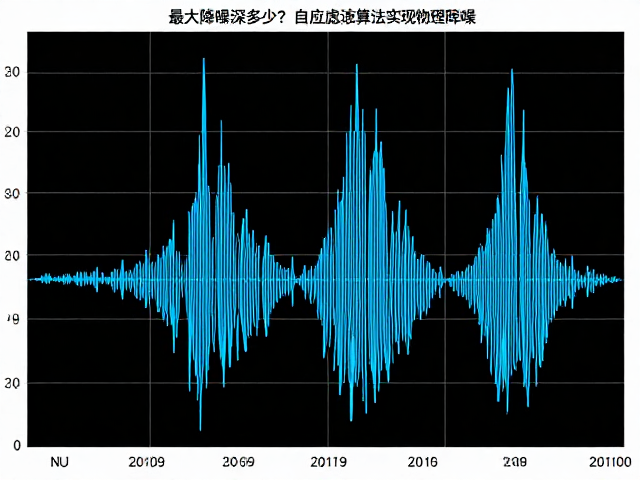
实测环境下的频谱分析与数据表现
为了验证自适应滤波在实际场景中的表现,测试通常选取高信噪比(SNR)环境与低信噪比环境两种极端情况进行对比分析。在标准白噪声背景下,当输入信号的信噪比为0dB时,经过多级自适应滤波处理后,输出信号的信噪提升量(SNR Improvement)通常可以达到10dB至15dB左右。这一数据区间反映了算法在强噪声环境下对有用信号的提取能力,同时也体现了滤波器系数收敛速度对最终降噪效果的关键影响。
在更为复杂的混合噪声场景中,例如包含50Hz工频干扰与高频风噪的环境,自适应滤波算法通过多通道处理或自适应噪声抵消技术,能够分别对不同频段进行针对性抑制。实测数据显示,针对50Hz窄带干扰的抑制深度可超过30dB,而对宽频带风噪的抑制效果则保持在10dB至20dB之间。值得注意的是,过深的降噪处理可能会导致语音信号的高频细节丢失,因此算法设计中通常引入感知加权模型,在降噪深度与音质保留之间寻找平衡点,确保语音的可懂度不受显著影响。
算法收敛性与实时处理的稳定性挑战
自适应滤波算法在实际部署中面临着收敛速度与稳定性之间的主要矛盾。快速收敛意味着算法能迅速适应噪声环境的突变,但在噪声功率剧烈波动时,过快的收敛可能导致滤波器系数震荡,进而引起输出信号的失真。为此,研究中常引入变步长机制,根据当前误差信号的大小动态调整步长因子。当误差较大时,增大步长以加快收敛;当误差较小且接近稳态时,减小步长以降低稳态误差,从而在动态响应和静态精度之间实现更优的折中。
实时处理对算法的计算复杂度提出了严苛要求。在嵌入式设备或移动终端上,每一步的迭代计算都需要在毫秒级时间内完成,以确保音频流的低延迟传输。这意味着算法必须经过严密的量化处理,将浮点运算转化为定点运算,同时优化内存访问策略。通过合理设计滤波器阶数,通常在4到16阶之间平衡计算负载与滤波性能,能够在主流处理器架构上实现稳定的实时降噪效果,避免因计算超时导致的音频断断续或同步错误。
不同声学场景下的适应性差异
自适应滤波算法在平稳噪声环境下的表现最为优异,因为此类噪声的统计特性变化缓慢,算法有足够的时间进行系数更新和收敛。然而,在非平稳噪声环境中,如人群嘈杂声或突发的敲击声,噪声的频谱特性瞬息万变,算法的跟踪能力成为决定降噪效果的关键。在此类场景下,基于深度学习的辅助自适应滤波器常被引入,通过深度学习模型预测噪声的特征向量,再驱动自适应滤波器进行快速响应,从而提升对突发性噪声的抑制能力。
此外,声源与噪声的空间分布特征也会影响自适应滤波的效果。在单麦克风系统中,算法主要依赖信号的时频特性进行分离,而在双麦克风或麦克风阵列系统中,可以利用信号间的空间相关性进行波束成形与噪声抵消。空间信息的引入使得算法能够区分出声源方向与噪声方向,从而在抑制噪声的同时更好地保留声源的方位感。这种空间自适应处理技术,进一步拓展了自适应滤波在复杂声学场景中的应用边界,使其能应对更具挑战性的分离任务。