虚拟声场构建的核心算法架构
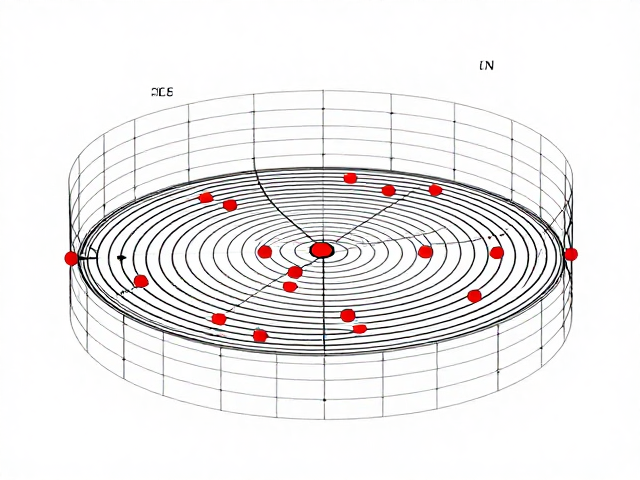
波场合成(WFS)与头部相关传输函数(HRTF)的结合,代表了从物理声学模拟到心理声学感知的深度融合。WFS基于惠更斯-菲涅耳原理,通过密集排列的扬声器阵列或虚拟声源,精确重构原始声场的波前,从而在较大听音区域内提供一致且高保真的三维声像定位。然而,WSA在近距离个人聆听场景下,受限于硬件密度与计算复杂度,往往难以直接应用于便携式设备或头戴式显示终端。引入HRTF技术后,算法通过卷积运算模拟声音在到达双耳前与耳廓、耳道、头部发生的散射、反射与衍射效应,将单声道或立体声信号转化为具有方向性特征的双耳信号。这种混合架构利用WFS提供宏观声场的空间连贯性,再由HRTF补充微观的双耳时间差(ITD)与双耳强度差(ILD),从而在有限硬件条件下重建出口径极大的沉浸式声场。
技术实现的关键在于空间采样与心理声学的耦合模型。传统WSA需要满足严格的空间奈奎斯特采样准则,以避免空间混叠现象,这通常要求极高的扬声器数量或复杂的数字波束成形算法。当与HRTF结合时,系统不再单纯依赖物理换能器的排布,而是通过数字信号处理构建虚拟的声学环境。具体而言,声源信号首先经过WFS波前重构引擎处理,生成各听音位置的理论声压分布,随后针对用户头部位置,应用个性化或非个性化的HRTF滤波器组。这一过程解决了传统WFS在大空间内听位移动导致的声像漂移问题,同时通过HRTF增强了近场聆听时的包裹感。实际工程中,常采用子带处理或快速卷积技术来降低实时计算的延迟,确保声像定位与头部转动之间的低延迟响应,这是构建无眩晕感虚拟环境的基础。
信号处理链路与实时渲染优化
在数字音频工作站或实时游戏引擎中,构建该混合声场涉及严密的信号流管理。输入端的声源定位数据通常由空间定位引擎提供,包含声源的三维坐标、方向向量及距离信息。这些数据首先送入WFS计算模块,通过求解近场波场合成方程,确定每个虚拟扬声器单元所需的驱动信号。考虑到实时性要求,现代实现多采用基于GPU加速的矩阵运算,将声源到听音区的传递函数矩阵进行预计算或动态更新。随后,生成的多通道信号并非直接输出,而是经过HRTF卷积链。此处需特别注意HRTF数据集的选择,通用HRTS(如KEMAR假人头采集数据)适用于大多数用户,而个性化HRTF则需通过激光扫描耳廓几何结构或心理声学测量生成,以消除个体间耳部结构差异带来的定位误差。
为了提升渲染效率并保证声学真实性,信号处理链路中常引入基于物理的混响模型与近场效应补偿。WFS天然能够处理早期反射声,但在虚拟环境中,完全求解所有反射路径计算成本极高。因此,混合架构常采用分层处理策略:近场声源直接使用WFS精确波前重构,中远场声源则结合HRTF与简化的几何声学反射模型。此外,头部相关脉冲响应(HRTIR)的长度通常较长,直接卷积会导致显著延迟。优化方案多采用频域重叠相加法(OLA)或基于快速傅里叶变换(FFT)的块处理技术,将计算负载分散至每个音频帧中。同时,动态自适应滤波器技术被用于处理头部转动过程中的HRTF插值,确保声像在用户头部运动时保持稳定的空间锁定,避免声像“粘滞”或跳跃,这是维持沉浸式体验连续性的关键技术指标。
应用场景与声学感知验证
该技术架构在虚拟现实(VR)、增强现实(AR)及元宇宙交互场景中展现出显著优势。在大型VR社交空间中,用户需要感知周围数百名虚拟角色的方位与远近,WFS提供了宽广的声场基底,使得声像能够自然分布在用户四周,而HRTF则确保了近处互动的清晰度与方向感。例如,在工业仿真培训中,操作员需准确判断机械故障发出的声源位置,混合架构通过高保真的波前重构,还原了机械噪声的频谱特征与空间分布,配合HRTf的双耳线索,使定位误差控制在可接受范围内。相较于传统立体声或仅依赖HRTF的3D音频方案,这种混合方法在减少听音区域“甜蜜点”限制方面效果显著,允许用户在较大范围内移动而不丢失空间线索。
声学感知验证通常依赖于严格的听音室测试与客观指标分析。主观评价实验多采用双耳录音回放对比,邀请经过训练的专业听众评估声像的宽度、深度及外部化程度。客观测量则涉及计算声场误差、定位准确率以及空间分辨率等参数。研究表明,在中等听音距离(1-3米)内,WFS与HRTF混合架构能显著降低声像模糊现象,特别是在处理瞬态声源时,其时间分辨率优于纯HRTF方案。此外,该技术对掩蔽效应的处理更为自然,能够模拟真实环境中声音在复杂空间内的遮蔽与遮挡效应。随着计算硬件性能的提升,实时渲染复杂波场与高精度HRTF卷积的计算开销正逐步降低,使得在主流消费级终端上部署高质量虚拟环绕声场成为技术现实,推动了沉浸式音频从专业制作领域向大众娱乐与交互设计的广泛渗透。